Como vimos en el post de interpretabilidad mecanicista, uno de sus objetivos es rastrear el flujo de información a través de un modelo. El residual stream (flujo residual) es uno de los conceptos más importantes para entender cómo funcionan internamente los modelos basados en Transformers.
En lugar de ver al Transformer como una serie de capas que transforman por completo la información paso a paso, este se describe como un flujo donde cada componente de cada capa añade información.
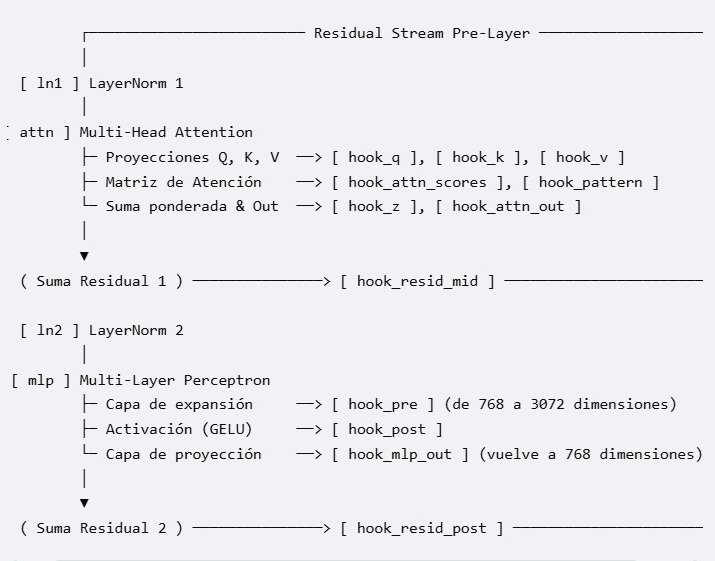
Cuando el token pasa por una capa (ya sea de atención o de perceptrón multicapa / MLP), esa capa no reemplaza el vector sino que calcula una corrección y la suma al vector original. A continuación, se ve el flujo a través de una capa que tiene una subcapa de atención y otra de red neuronal feedforward.
Vamos a ver un ejemplo con código usando la librería TransformerLens. Primero, importamos las librerías, cargamos el modelo gpt2-small, introducimos un prompt y ejecutamos el método “run_with_cache” para guardar las activaciones.
import torch
from transformer_lens import HookedTransformer

# 1. Cargar un modelo pequeño de ejemplo
model = HookedTransformer.from_pretrained("gpt2-small")

# 2. Tu frase y la capa que quieres inspeccionar
texto = "El gato bebe leche"
capa = 5

# 3. Correr el modelo guardando las activaciones (cache)
logits, cache = model.run_with_cache(texto)
Para la capa 5, extraemos el vector de activación del último token para la salida del MLP y la salida de la capa o flujo acumulado. Hay que tener en cuenta que la salida de la capa será el flujo intermedio más la salida del MLP, como hemos visto en la fórmula. Comprobamos que los dos vectores son diferentes.
# 4. Extraer ambos vectores en la posición del último token
# [posicion_token, dimension_del_modelo]
vector_mlp_puro = cache[f"blocks.{capa}.hook_mlp_out"][0, -1, :]
vector_flujo_acumulado = cache[f"blocks.{capa}.hook_resid_post"][0, -1, :]

# 5. COMPROBACIÓN NUMÉRICA
print(f"Salida MLP:\n{vector_mlp_puro[:10]}\n\nFlujo Acumulado:\n{vector_flujo_acumulado[:10]}")
print("¿Son el mismo vector?:", torch.equal(vector_mlp_puro, vector_flujo_acumulado))
Extraemos el flujo intermedio, vemos el fujo intermedio, la salida de la subcapa MLP y el flujo acumulado y comprobamos que este último es la suma de los dos primeros.
# Verás que la suma se cumple perfectamente en el código:
# Cambiado a 'hook_resid_mid' para denotar el estado intermedio de la corriente residual
vector_flujo_antes_de_mlp = cache[f"blocks.{capa}.hook_resid_mid"][0, -1, :]
print(f"Flujo intermedio:\n{vector_flujo_antes_de_mlp[:3]}\n\nSalida MLP:\n{vector_mlp_puro[:3]}\n\nFlujo Acumulado:\n{vector_flujo_acumulado[:3]}")
print("¿Se cumple la suma residual?:", torch.allclose(vector_flujo_acumulado, vector_flujo_antes_de_mlp + vector_mlp_puro, atol=1e-5))
A continuación, vemos la salida del programa y como el flujo acumulado es distinto de la salida MLP y se corresponde con la suma del flujo intermedio más la salida de esa subcapa MLP.
Loaded pretrained model gpt2-small into HookedTransformer
Salida MLP:
tensor([-0.2385,  0.3559, -0.0678, -0.4029,  0.5167,  0.7817, -0.5805, -0.7563,
        -0.0890,  0.0681])

Flujo Acumulado:
tensor([-4.2627,  2.1355,  1.9207, -0.3329,  2.3054,  1.3431,  1.5575, -0.4302,
         2.0261,  1.4831])
¿Son el mismo vector?: False
Flujo intermedio:
tensor([-4.0242,  1.7796,  1.9885])

Salida MLP:
tensor([-0.2385,  0.3559, -0.0678])

Flujo Acumulado:
tensor([-4.2627,  2.1355,  1.9207])
¿Se cumple la suma residual?: True
Por último, imprimimos los componentes de la capa 5 que hemos estudiado en el modelo gpt2-small.
TransformerBlock(
  (ln1): LayerNormPre(
    (hook_scale): HookPoint(name='blocks.5.ln1.hook_scale')
    (hook_normalized): HookPoint(name='blocks.5.ln1.hook_normalized')
  )
  (ln2): LayerNormPre(
    (hook_scale): HookPoint(name='blocks.5.ln2.hook_scale')
    (hook_normalized): HookPoint(name='blocks.5.ln2.hook_normalized')
  )
  (attn): Attention(
    (hook_k): HookPoint(name='blocks.5.attn.hook_k')
    (hook_q): HookPoint(name='blocks.5.attn.hook_q')
    (hook_v): HookPoint(name='blocks.5.attn.hook_v')
    (hook_z): HookPoint(name='blocks.5.attn.hook_z')
    (hook_attn_scores): HookPoint(name='blocks.5.attn.hook_attn_scores')
    (hook_pattern): HookPoint(name='blocks.5.attn.hook_pattern')
    (hook_result): HookPoint(name='blocks.5.attn.hook_result')
  )
  (mlp): MLP(
    (hook_pre): HookPoint(name='blocks.5.mlp.hook_pre')
    (hook_post): HookPoint(name='blocks.5.mlp.hook_post')
  )
  (hook_attn_in): HookPoint(name='blocks.5.hook_attn_in')
  (hook_q_input): HookPoint(name='blocks.5.hook_q_input')
  (hook_k_input): HookPoint(name='blocks.5.hook_k_input')
  (hook_v_input): HookPoint(name='blocks.5.hook_v_input')
  (hook_mlp_in): HookPoint(name='blocks.5.hook_mlp_in')
  (hook_attn_out): HookPoint(name='blocks.5.hook_attn_out')
  (hook_mlp_out): HookPoint(name='blocks.5.hook_mlp_out')
  (hook_resid_pre): HookPoint(name='blocks.5.hook_resid_pre')
  (hook_resid_mid): HookPoint(name='blocks.5.hook_resid_mid')
  (hook_resid_post): HookPoint(name='blocks.5.hook_resid_post')
)
Y vemos un diagrama del flujo residual para la capa que hemos estudiado.

Deja una respuesta
Lo siento, debes estar conectado para publicar un comentario.