Esta entrada es parte del curso de Deep learning con PyTorch. El paquete torch.nn de PyTorch contiene multitud de clases que nos permiten crear de una manera intuitiva redes neuronales y a la vez tener un nivel de detalle y control de los componentes de las mismas. Una de las clases más importantes de torch.nn... Seguir leyendo →
Fundamentos de PyTorch. Tensores
Esta entrada es parte del curso de Deep learning con PyTorch. Uno de los conceptos más frecuentes en machine learning es el de tensor. Un tensor es la generalización del concepto de vector utilizando el rango para definir el número de indices del tensor. Por ejemplo, un vector es un tensor de rango 1, una... Seguir leyendo →
Optimización bayesiana con PyTorch y Ax

Esta entrada es parte del curso de Deep learning con PyTorch. En un post pasado presentamos la optimización Bayesiana y las dos nuevas herramientas abiertas de Facebook, Ax y BoTorch. Ax es una herramienta de alto nivel para gestionar experimentos adaptativos y BoTorch una librería de optimización bayesiana. En este post vamos a ver un... Seguir leyendo →
Nuevas herramientas de optimización bayesiana en PyTorch

Esta entrada es parte del curso de Deep learning con PyTorch. Con frecuencia en machine learning queremos optimizar los hiperparámetros de un modelo. Por ejemplo, en una red neuronal queremos saber el número de capas, el número de unidades por capa o la tasa de aprendizaje (learning rate) que logran un mejor comportamiento. Este problema... Seguir leyendo →
Autograd, clave de la flexibilidad de PyTorch

Esta entrada es parte del curso de Deep learning con PyTorch. En los últimos dos años hemos visto como PyTorch, el framework basado en Torch para Deep Learning creado por Facebook, está siendo una alternativa potente a Tensorflow. Una de las principales ventajas de PyTorch es que es un framework imperativo, en el que las... Seguir leyendo →
PyTorch con CUDA en Colab
Esta entrada es parte del curso de Deep learning con PyTorch. En un post pasado vimos como las GPUs (graphics processing units) han impulsado el desarrollo del Deep Learning en los últimos años. Las GPUs, gracias a su estructura en paralelo, son muy eficientes para algoritmos con procesamiento de datos en paralelo como los usados... Seguir leyendo →
Redes convolucionales, de la invarianza a la equivarianza traslacional

En un post anterior, utilizamos una red neuronal convolucional para ver como evolucionaban las representaciones en las capas intermedias en el proceso de entrenamiento. La arquitectura de la red convolucional empleada y un resumen de ella se pueden ver a continuación: Una de las capas más utilizadas en una red convolucional es la capa de... Seguir leyendo →
Entrenamiento de redes convolucionales y teoría de la información

En un post pasado de teoría de la información en deep learning vimos como Naftali Tishby y su equipo han aplicado con éxito el método del cuello de botella de la información al deep learning. En sus simulaciones analizaron cuánta información retiene cada capa de una red neuronal de la entrada y de la salida... Seguir leyendo →
Spark para Machine learning en Google Colab
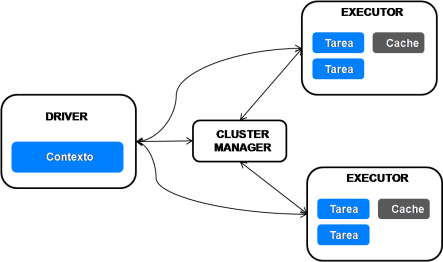
Con el incremento en la cantidad de datos y procesamiento en los últimos años, se ha hecho necesario disponer de nuevos paradigmas de computación paralela que permitan repartir la carga de procesamiento en múltiples máquinas mejorando así la eficiencia del proceso. Fruto de esta necesidad surgió MapReduce y Apache Spark, una extensión de este. Spark... Seguir leyendo →
Word embeddings y skip-gram

En posts anteriores vimos que las representaciones distribuidas de las palabras permiten extraer mucha información y han mejorado el rendimiento de las aplicaciones de procesamiento de lenguaje natural. Los Word embeddings son un claro ejemplo de la importancia y el potencial del aprendizaje no supervisado de representaciones. A partir de un cuerpo de texto de... Seguir leyendo →
